SEO Article
X-Robots-Tag คืออะไร? ควบคุม Index ไฟล์ PDF อย่างไร
X-Robots-Tag คืออะไร? ควบคุมการ Index ไฟล์ PDF และไฟล์ที่ไม่มี HTML อย่างไร
เว็บไซต์ไม่ได้มีเฉพาะหน้า HTML ที่เป็นบทความหรือหน้าสินค้าเท่านั้น หลายเว็บไซต์ยังมีไฟล์ PDF เอกสาร รูปภาพ และไฟล์ประเภทอื่นที่ Search Engine สามารถค้นพบผ่านลิงก์หรือ Sitemap ได้ ปัญหาคือไฟล์บางประเภทไม่มีส่วน <head> ของ HTML จึงไม่สามารถใส่ Robots Meta Tag แบบหน้าเว็บทั่วไปได้ ในสถานการณ์นี้ X-Robots-Tag เป็นอีกวิธีที่ช่วยส่งคำสั่งเกี่ยวกับการ Index ผ่าน HTTP Response Header จาก Server โดยตรง เจ้าของเว็บไซต์จึงสามารถกำหนด noindex ให้เอกสาร PDF หรือใช้คำสั่ง Robots อื่นกับ Resource ที่เหมาะสมได้ การเข้าใจ X-Robots-Tag ช่วยให้จัดการไฟล์และ URL ได้ละเอียดขึ้น โดยเฉพาะเว็บไซต์ที่มีเอกสารดาวน์โหลดจำนวนมากและไม่ต้องการให้ไฟล์บางส่วนปรากฏเป็นผลการค้นหาโดยตรง
X-Robots-Tag คืออะไร และทำงานตรงไหน
X-Robots-Tag คือ HTTP Response Header ที่ใช้ส่งคำสั่งเกี่ยวกับการ Index และการแสดงเนื้อหาของ URL ให้ Search Engine ที่รองรับ
ตัวอย่างเช่น Server สามารถส่ง Header:
X-Robots-Tag: noindex
เมื่อ Crawler ที่รองรับเข้าถึง URL และได้รับ Response Header ดังกล่าว ก็สามารถนำคำสั่ง noindex ไปใช้กับ URL นั้นได้
ความแตกต่างสำคัญเมื่อเทียบกับ Robots Meta Tag คือ X-Robots-Tag ไม่จำเป็นต้องอยู่ภายใน HTML
Google อธิบายว่า X-Robots-Tag สามารถใช้กับ Resource ที่ไม่ใช่ HTML เช่น PDF, Video และ Image ได้ จึงเหมาะกับกรณีที่ไม่สามารถใส่ <meta> tag ลงในตัวไฟล์ได้โดยตรง
X-Robots-Tag กับ Robots Meta Tag ต่างกันอย่างไร
ทั้งสองวิธีมีเป้าหมายใกล้เคียงกัน แต่ตำแหน่งที่ส่งคำสั่งแตกต่างกัน
Robots Meta Tag อยู่ใน HTML เช่น
<meta name="robots" content="noindex">
ส่วน X-Robots-Tag ถูกส่งมาจาก Server ใน HTTP Header เช่น
X-Robots-Tag: noindex
หากเป็นบทความหรือหน้า Landing Page ปกติ Robots Meta Tag มักจัดการได้ง่ายผ่าน CMS หรือ SEO Plugin
แต่หากเป็น
- รูปภาพ
- วิดีโอ
- ไฟล์เอกสาร
- Resource ที่ไม่มี HTML
X-Robots-Tag จะมีประโยชน์มากขึ้น เพราะสามารถควบคุมจากฝั่ง Server ได้
จึงไม่ควรมองว่าเครื่องมือหนึ่งดีกว่าอีกเครื่องมือหนึ่ง แต่ควรเลือกให้เหมาะกับ Resource ที่กำลังจัดการ
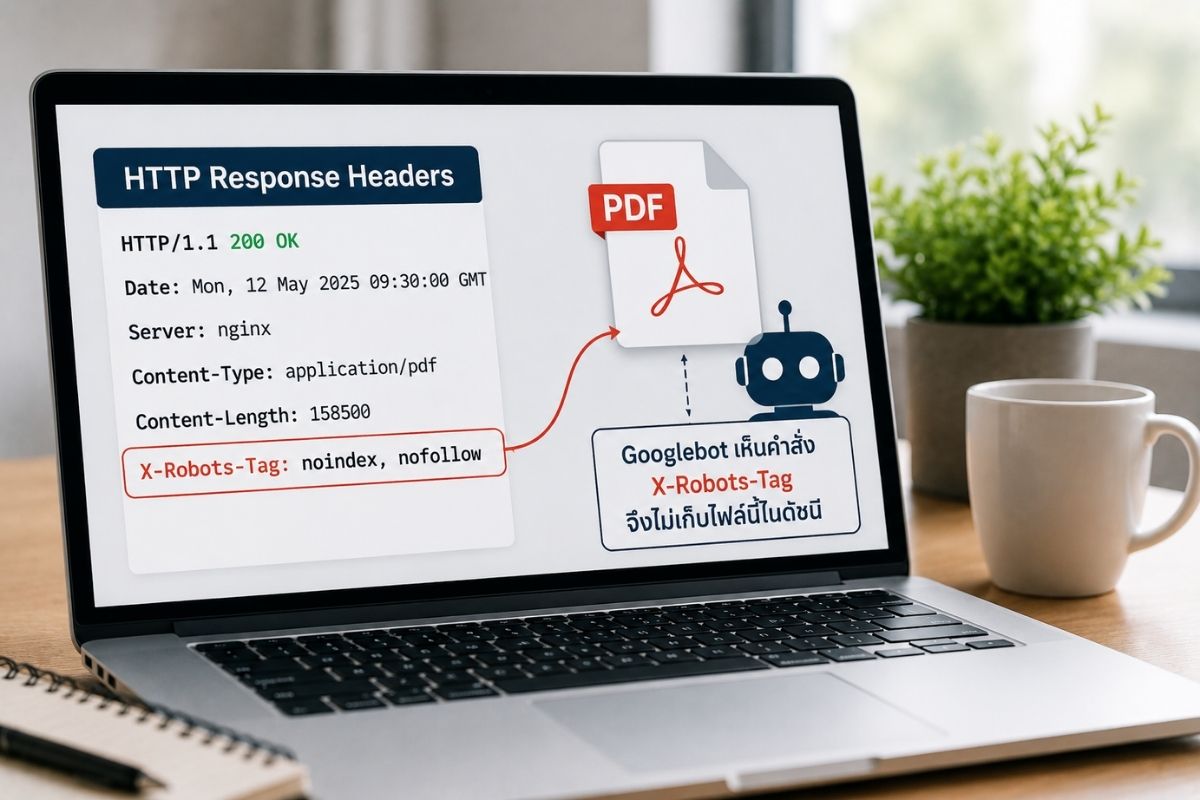
X-Robots-Tag ใช้ noindex กับไฟล์ PDF ได้อย่างไร
ลองนึกถึงเว็บไซต์บริษัทที่มี PDF จำนวนมาก เช่น ใบเสนอราคาเก่า คู่มือภายใน เอกสารเวอร์ชันก่อนหน้า หรือ Catalog ที่ไม่ต้องการให้ผู้ใช้ค้นเจอจาก Google โดยตรง
หาก Google สามารถค้นพบ URL ของ PDF เหล่านั้น ไฟล์ก็มีโอกาสเข้าสู่ระบบ Index ได้
แต่ PDF ไม่มี <head> แบบหน้า HTML จึงไม่สามารถใส่ Robots Meta Tag ด้วยวิธีเดียวกับบทความทั่วไป
เจ้าของ Server สามารถกำหนด Response Header ให้ไฟล์ที่ต้องการ เช่น
X-Robots-Tag: noindex
เมื่อ Googlebot เข้าถึง PDF และได้รับ Header นี้ Google สามารถใช้คำสั่งดังกล่าวเพื่อไม่แสดง Resource นั้นใน Search ตามหลักการของ noindex
จุดสำคัญคือ Googlebot ต้องสามารถ Crawl URL เพื่ออ่าน Header ได้
X-Robots-Tag ไม่ควรใช้แทนการรักษาความปลอดภัย
เรื่องนี้สำคัญมาก โดยเฉพาะเมื่อพูดถึง PDF และเอกสารบริษัท
noindex ไม่ใช่ระบบรักษาความปลอดภัย
หากเอกสารเป็นข้อมูลส่วนตัว เอกสารลูกค้า เอกสารทางการเงิน หรือข้อมูลที่บุคคลทั่วไปไม่ควรเข้าถึง การใส่ X-Robots-Tag เพียงอย่างเดียวไม่เพียงพอ เพราะผู้ที่รู้ URL อาจยังสามารถเปิดไฟล์ได้
กรณีข้อมูลที่ต้องจำกัดการเข้าถึงควรใช้ระบบ Authentication, Authorization หรือการควบคุมสิทธิ์จาก Server อย่างเหมาะสม
X-Robots-Tag มีหน้าที่เกี่ยวกับพฤติกรรมของ Search Engine ที่รองรับ ไม่ใช่การป้องกันบุคคลจากการเข้าถึงไฟล์
X-Robots-Tag รองรับคำสั่งอะไรได้บ้าง
X-Robots-Tag สามารถใช้ Robots Rules หลายประเภทที่ Google รองรับ ไม่ได้จำกัดเฉพาะ noindex
ตัวอย่างคำสั่งที่ควรรู้ ได้แก่
noindex— ไม่ต้องการให้ Resource ปรากฏใน Searchnofollow— ไม่ต้องการให้ Google ติดตามลิงก์ตามความหมายของคำสั่งnosnippet— ไม่ให้แสดง Text Snippet และ Video Previewmax-snippet— จำกัดความยาว Text Snippetmax-image-preview— ควบคุมขนาด Image Previewmax-video-preview— จำกัด Video Preview
Google ระบุว่าสามารถรวมหลาย Rule เข้าด้วยกันได้ และสามารถกำหนด Rule สำหรับ Crawler เฉพาะตัวได้ด้วย
แต่ก่อนใช้งานจริงควรถามก่อนว่าต้องการควบคุมอะไร เพราะการใส่ Rule มากเกินความจำเป็นทำให้การดูแลเว็บไซต์ซับซ้อนขึ้น
X-Robots-Tag กับ robots.txt ไม่ใช่สิ่งเดียวกัน
แม้ชื่อจะมีคำว่า Robots เหมือนกัน แต่หน้าที่ต่างกัน
robots.txt ใช้ควบคุมว่าบาง Crawler สามารถ Request URL หรือ Resource ใดได้หรือไม่ตาม Robots Exclusion Protocol
ส่วน X-Robots-Tag ส่งคำสั่งเกี่ยวกับการ Index และการนำ Resource ไปใช้ใน Search
จุดที่ต้องระวังคือ หากต้องการให้ Google เห็น
X-Robots-Tag: noindex
Googlebot ต้องสามารถ Request Resource นั้นและได้รับ HTTP Header ก่อน
หาก URL ถูก Disallow ผ่าน robots.txt จน Googlebot เข้าไม่ได้ ระบบก็อาจไม่เห็นคำสั่ง noindex ที่ Server ส่งออกมา
หลักการนี้เหมือนกับการใช้ Robots Meta Tag noindex ในหน้า HTML
X-Robots-Tag เหมาะกับเว็บไซต์แบบไหน
เว็บไซต์ขนาดเล็กที่มีแต่หน้า WordPress ปกติอาจแทบไม่จำเป็นต้องแตะ X-Robots-Tag เพราะ SEO Plugin สามารถจัดการ Robots Meta Tag ของหน้า HTML ได้อยู่แล้ว
แต่ X-Robots-Tag จะเริ่มมีประโยชน์กับเว็บไซต์ที่มี Resource หลายประเภท เช่น
เว็บไซต์มหาวิทยาลัยที่มีเอกสาร PDF จำนวนมาก เว็บไซต์บริษัทที่เก็บ Catalog หลายเวอร์ชัน เว็บดาวน์โหลดเอกสาร เว็บไซต์สื่อที่มี Video หรือ Image URL จำนวนมาก รวมถึงระบบที่ต้องการกำหนด Robots Rule ผ่าน Server Configuration
ข้อดีคือสามารถวาง Rule ตามประเภทไฟล์หรือ URL Pattern ได้
แต่ข้อเสียคือการตั้งค่าผิดอาจกระทบไฟล์จำนวนมากพร้อมกัน จึงต้องตรวจสอบหลัง Deploy ทุกครั้ง
วิธีตรวจว่า X-Robots-Tag ทำงานหรือไม่
การเปิดหน้าเว็บด้วย Browser อย่างเดียวอาจไม่เห็น X-Robots-Tag เพราะข้อมูลอยู่ใน HTTP Response Header
วิธีตรวจพื้นฐานคือดู Response Headers ของ URL ผ่าน Developer Tools หรือเครื่องมือตรวจ HTTP Header
สิ่งที่ต้องหา เช่น
X-Robots-Tag: noindex
หลังตั้งค่าแล้วควรตรวจอย่างน้อย 3 เรื่อง
- URL ที่ต้องการได้รับ Header จริงหรือไม่
- URL อื่นที่ไม่เกี่ยวข้องโดน Rule ไปด้วยหรือไม่
- Googlebot สามารถเข้าถึง URL เพื่ออ่าน Header ได้หรือไม่
หากตั้ง Rule แบบครอบคลุมไฟล์ .pdf ทั้งเว็บไซต์ ยิ่งควรตรวจให้แน่ใจว่าไม่มี PDF สำคัญที่ต้องการให้ค้นหาได้ถูก noindex ไปพร้อมกัน
X-Robots-Tag ควรใช้เมื่อใด และเมื่อใดไม่จำเป็น
หาก Resource เป็นหน้า HTML ธรรมดาและ CMS สามารถควบคุม Robots Meta Tag ได้ง่าย การใช้ Meta Tag อาจตรงไปตรงมากว่า
แต่ถ้า Resource ไม่มี HTML หรือจำเป็นต้องควบคุมจากระดับ HTTP Header การใช้ X-Robots-Tag จะเหมาะกว่า
หลักง่าย ๆ คือ
หน้า HTML → พิจารณา Robots Meta Tag
PDF / Media / Non-HTML Resource → พิจารณา X-Robots-Tag
ข้อมูลที่ต้องเป็นความลับ → ใช้ระบบควบคุมสิทธิ์ ไม่ใช่พึ่ง noindex
การเลือกเครื่องมือให้ตรงกับปัญหาช่วยลดความผิดพลาดและทำให้ Technical SEO ดูแลต่อได้ง่ายกว่า
สรุป
X-Robots-Tag คือ HTTP Response Header ที่ช่วยส่งคำสั่งเกี่ยวกับการ Index และการแสดง Resource ใน Search โดยจุดเด่นคือสามารถใช้กับไฟล์ที่ไม่มี HTML เช่น PDF, Image หรือ Video ได้ จึงช่วยเติมช่องว่างจาก Robots Meta Tag ที่ต้องใส่ใน HTML อย่างไรก็ตาม X-Robots-Tag ไม่ใช่ระบบรักษาความปลอดภัย และ Googlebot ต้องสามารถเข้าถึง Resource เพื่ออ่าน Header ที่กำหนดไว้ การใช้งานจึงควรเริ่มจากการระบุให้ชัดว่า URL หรือไฟล์ประเภทใดต้องการให้ Index จากนั้นจึงเลือก noindex หรือ Rule อื่นให้เหมาะสม พร้อมตรวจ HTTP Response หลังตั้งค่าทุกครั้ง เพื่อป้องกันการ noindex Resource สำคัญโดยไม่ตั้งใจ
คำถามที่พบบ่อย (FAQ)
X-Robots-Tag คืออะไร?
X-Robots-Tag คือ HTTP Response Header ที่ใช้ส่งคำสั่งเกี่ยวกับการ Index และการแสดง Resource ใน Search Engine ที่รองรับ
X-Robots-Tag ใช้กับ PDF ได้หรือไม่?
ได้ และเป็นหนึ่งในกรณีที่มีประโยชน์ เพราะ PDF ไม่มี HTML <head> สำหรับใส่ Robots Meta Tag แบบหน้าเว็บทั่วไป
X-Robots-Tag กับ noindex เหมือนกันหรือไม่?
X-Robots-Tag เป็นช่องทางสำหรับส่ง Robots Rule ส่วน noindex เป็นหนึ่งใน Rule ที่สามารถส่งผ่าน X-Robots-Tag ได้
ใช้ X-Robots-Tag ป้องกันไฟล์ลับได้หรือไม่?
ไม่ควร เพราะ noindex ไม่ได้ป้องกันผู้ใช้ที่รู้ URL จากการเข้าถึงไฟล์ ข้อมูลที่เป็นความลับควรใช้ระบบควบคุมสิทธิ์ที่เหมาะสม
ถ้าบล็อก PDF ใน robots.txt แล้วใส่ X-Robots-Tag noindex ด้วยได้หรือไม่?
ไม่ใช่แนวทางที่เหมาะ หาก Googlebot ถูกบล็อกไม่ให้ Request PDF ก็อาจไม่สามารถเห็น HTTP Header noindex ของไฟล์นั้นได้