SEO Article
Robots.txt คืออะไร? วิธีตั้งค่าให้ Google เข้าใจเว็บไซต์และทำ SEO ได้ถูกต้อง
Robots.txt คืออะไร? วิธีใช้งานให้ Google เข้าใจเว็บไซต์และเก็บข้อมูลได้อย่างถูกต้อง
เมื่อพูดถึงการทำ Technical SEO หลายคนมักให้ความสำคัญกับ XML Sitemap แต่ยังมีอีกหนึ่งไฟล์ที่มีบทบาทสำคัญไม่แพ้กัน นั่นคือ robots.txt ซึ่งเป็นไฟล์ขนาดเล็กที่ใช้กำหนดว่าหน้าใดหรือโฟลเดอร์ใดบนเว็บไซต์ที่ Search Engine สามารถเข้าถึงได้ และส่วนใดที่ไม่ควรเข้าไปสำรวจ แม้ไฟล์ robots.txt จะไม่ได้ช่วยเพิ่มอันดับเว็บไซต์โดยตรง แต่หากตั้งค่าอย่างเหมาะสม จะช่วยให้ Google ใช้ทรัพยากรในการ Crawl เว็บไซต์ได้อย่างมีประสิทธิภาพ ลดการสำรวจหน้าที่ไม่จำเป็น และช่วยให้หน้าเว็บสำคัญได้รับความสนใจมากขึ้น บทความนี้จะอธิบายว่า robots.txt คืออะไร มีหน้าที่อย่างไร และควรใช้งานแบบไหนเพื่อสนับสนุนการทำ SEO อย่างถูกต้อง
Robots.txt คืออะไร และมีหน้าที่อย่างไร
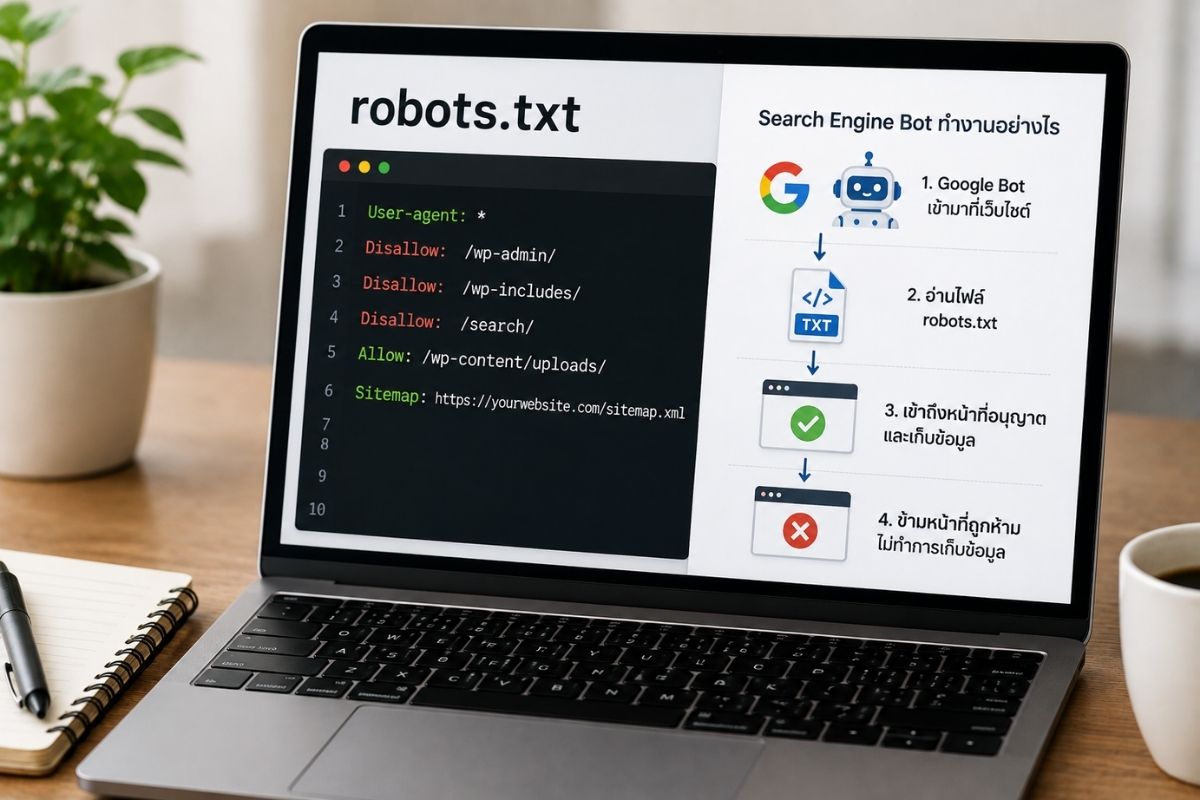
robots.txt คือไฟล์ข้อความที่อยู่ในตำแหน่งราก (Root Directory) ของเว็บไซต์ ทำหน้าที่เป็นชุดคำสั่งสำหรับ Search Engine Bot เพื่อบอกว่าส่วนใดของเว็บไซต์สามารถเข้าไปสำรวจข้อมูลได้ และส่วนใดควรถูกจำกัด
ไฟล์นี้มีประโยชน์หลายด้าน เช่น
- ช่วยควบคุมการ Crawl ของ Search Engine
- ลดการสำรวจหน้าที่ไม่จำเป็น
- ประหยัด Crawl Budget สำหรับเว็บไซต์ขนาดใหญ่
- ป้องกันการเข้าถึงโฟลเดอร์บางประเภท
- ระบุตำแหน่งของ XML Sitemap
อย่างไรก็ตาม robots.txt ไม่ใช่เครื่องมือสำหรับป้องกันข้อมูลลับ เพราะหน้าเว็บที่ถูกบล็อกอาจยังสามารถเข้าถึงได้หากทราบ URL โดยตรง
Robots.txt ช่วยสนับสนุนการทำ SEO อย่างไร
แม้ robots.txt จะไม่ใช่ปัจจัยที่ทำให้อันดับเว็บไซต์สูงขึ้นโดยตรง แต่การตั้งค่าอย่างถูกต้องจะช่วยให้ Google สำรวจเว็บไซต์ได้มีประสิทธิภาพมากขึ้น
ประโยชน์ที่สำคัญ ได้แก่
- ช่วยให้ Google ใช้ Crawl Budget ได้คุ้มค่า
- ลดการสำรวจไฟล์หรือโฟลเดอร์ที่ไม่จำเป็น
- เพิ่มโอกาสให้หน้าเว็บสำคัญถูกสำรวจเร็วขึ้น
- ลดปัญหาการเก็บข้อมูลซ้ำซ้อน
- สนับสนุนการทำงานร่วมกับ XML Sitemap
เว็บไซต์ที่มีบทความจำนวนมากหรือร้านค้าออนไลน์ที่มีสินค้าหลายพันรายการ จะได้รับประโยชน์จากการจัดการ Crawl Budget อย่างเหมาะสม
Robots.txt ควรอนุญาตและบล็อกส่วนใดของเว็บไซต์
การตั้งค่า robots.txt ควรพิจารณาตามลักษณะของเว็บไซต์ ไม่ใช่บล็อกทุกส่วนโดยไม่มีเหตุผล
โดยทั่วไปควรอนุญาตให้ Google เข้าถึง
- บทความ
- หน้าสินค้า
- หน้าบริการ
- หมวดหมู่หลัก
- รูปภาพที่ต้องการให้ค้นหา
ส่วนที่มักพิจารณาจำกัดการสำรวจ ได้แก่
- หน้าเข้าสู่ระบบ
- หน้าผู้ดูแลระบบ
- โฟลเดอร์ทดสอบ
- หน้าค้นหาภายในเว็บไซต์
- ไฟล์ชั่วคราวที่ไม่จำเป็น
การตั้งค่าควรระมัดระวัง เพราะหากบล็อกผิดตำแหน่ง อาจทำให้ Google ไม่สามารถเข้าถึงหน้าเว็บสำคัญได้
วิธีตรวจสอบ Robots.txt ว่าทำงานถูกต้องหรือไม่
หลังจากสร้างหรือแก้ไขไฟล์ robots.txt ควรตรวจสอบว่าคำสั่งทำงานถูกต้อง เพื่อป้องกันผลกระทบต่อ SEO
แนวทางที่แนะนำ ได้แก่
- เปิดไฟล์ robots.txt ผ่านเบราว์เซอร์
- ตรวจสอบว่าไม่มีคำสั่งบล็อกหน้าสำคัญ
- ตรวจสอบว่า XML Sitemap ถูกระบุไว้
- ใช้ Google Search Console ตรวจสอบสถานะการ Crawl
- ทดสอบการเข้าถึงหน้าเว็บที่สำคัญ
การตรวจสอบเป็นประจำจะช่วยลดความเสี่ยงที่เว็บไซต์จะหายไปจากผลการค้นหาโดยไม่ตั้งใจ
ข้อผิดพลาดเกี่ยวกับ Robots.txt ที่พบได้บ่อย
แม้ robots.txt จะเป็นไฟล์ขนาดเล็ก แต่ความผิดพลาดเพียงเล็กน้อยก็อาจส่งผลกระทบต่อเว็บไซต์ทั้งระบบ
ข้อผิดพลาดที่พบเป็นประจำ ได้แก่
- บล็อกเว็บไซต์ทั้งหมดโดยไม่ตั้งใจ
- บล็อกไฟล์ CSS หรือ JavaScript ที่จำเป็น
- ลืมระบุ XML Sitemap
- ใช้คำสั่งผิดรูปแบบ
- ไม่ตรวจสอบหลังแก้ไขเว็บไซต์
- คิดว่า robots.txt สามารถป้องกันข้อมูลลับได้
การตรวจสอบทุกครั้งก่อนเผยแพร่การเปลี่ยนแปลง จะช่วยลดความเสี่ยงและทำให้เว็บไซต์ทำงานได้อย่างถูกต้อง
สรุป
robots.txt เป็นองค์ประกอบสำคัญของ Technical SEO ที่ช่วยกำหนดแนวทางการสำรวจเว็บไซต์ของ Search Engine แม้จะไม่ได้ช่วยเพิ่มอันดับเว็บไซต์โดยตรง แต่สามารถช่วยให้ Google ใช้ทรัพยากรในการ Crawl ได้อย่างมีประสิทธิภาพ สนับสนุนการทำงานร่วมกับ XML Sitemap และลดการสำรวจหน้าที่ไม่จำเป็น การตั้งค่า robots.txt ควรทำอย่างระมัดระวัง ตรวจสอบความถูกต้องเป็นประจำ และใช้ร่วมกับเครื่องมืออย่าง Google Search Console เพื่อให้เว็บไซต์พร้อมสำหรับการจัดทำดัชนีและการทำ SEO ในระยะยาว
คำถามที่พบบ่อย (FAQ)
Robots.txt คืออะไร?
robots.txt คือไฟล์ข้อความที่ใช้กำหนดว่าหน้าเว็บหรือโฟลเดอร์ใดที่ Search Engine สามารถเข้าไปสำรวจข้อมูลได้ และส่วนใดควรถูกจำกัดการเข้าถึง
Robots.txt มีผลต่ออันดับ SEO หรือไม่?
ไม่มีผลโดยตรงต่ออันดับ แต่ช่วยให้ Google สำรวจเว็บไซต์ได้มีประสิทธิภาพมากขึ้น ซึ่งส่งผลดีต่อการจัดการ Crawl Budget และการจัดทำดัชนี
Robots.txt กับ XML Sitemap แตกต่างกันอย่างไร?
robots.txt ใช้กำหนดว่าหน้าใดควรหรือไม่ควรถูกสำรวจ ส่วน XML Sitemap ใช้แนะนำหน้าเว็บที่ต้องการให้ Google ค้นพบและจัดทำดัชนี ทั้งสองไฟล์ทำงานร่วมกันเพื่อช่วยให้ Search Engine เข้าใจเว็บไซต์ได้ดียิ่งขึ้น
เว็บไซต์ WordPress มี robots.txt หรือไม่?
โดยทั่วไป WordPress สามารถสร้าง robots.txt แบบพื้นฐานได้ และเจ้าของเว็บไซต์สามารถแก้ไขหรือสร้างไฟล์ robots.txt เองเพื่อปรับแต่งการทำงานเพิ่มเติมได้
ตรวจสอบ robots.txt ได้จากที่ไหน?
สามารถเปิดผ่านเบราว์เซอร์โดยพิมพ์ https://ชื่อโดเมนของคุณ/robots.txt และใช้ Google Search Console เพื่อตรวจสอบผลการทำงานร่วมกับการ Crawl ของ Google
อ่านเพิ่มเติม: