SEO Article
Index Bloat คืออะไร? URL เยอะเกินไปส่งผลต่อ SEO อย่างไร
Index Bloat คืออะไร? เมื่อเว็บไซต์มี URL จำนวนมากเกินจำเป็นควรจัดการอย่างไร
เว็บไซต์ที่มีหน้าเยอะไม่ได้หมายความว่าจะมี SEO ที่แข็งแรงกว่าเว็บไซต์ที่มีหน้าน้อยเสมอไป เพราะในบางกรณีระบบเว็บไซต์สามารถสร้าง URL เพิ่มขึ้นจำนวนมากจาก Tag, Filter, Search Page, Parameter, Archive หรือหน้าที่มีเนื้อหาใกล้เคียงกัน จน Google ต้องพบและประเมิน URL มากกว่าหน้าสำคัญที่เว็บไซต์ต้องการให้คนค้นหา ปัญหาลักษณะนี้มักถูกเรียกในวงการ SEO ว่า Index Bloat แม้คำนี้ไม่ใช่ชื่อรายงานอย่างเป็นทางการของ Google แต่ใช้สื่อถึงสถานการณ์ที่เว็บไซต์มี URL จำนวนมากซึ่งไม่มีเหตุผลชัดเจนที่จะต้องปรากฏใน Search การแก้ปัญหาจึงไม่ได้หมายถึงพยายามลดจำนวนหน้าทั้งหมด แต่ต้องแยกให้ได้ว่าหน้าใดมีคุณค่า หน้าใดซ้ำ และหน้าใดไม่ควรถูกนำเสนอเป็นผลการค้นหา
Index Bloat คืออะไร และไม่ได้หมายถึงเว็บไซต์ใหญ่เสมอไป
Index Bloat เป็นคำที่ใช้ในวงการ SEO เพื่ออธิบายเว็บไซต์ที่มี URL จำนวนมากซึ่งถูกค้นพบหรือเข้าสู่กระบวนการจัดทำดัชนี ทั้งที่หลายหน้าไม่มีคุณค่าเพียงพอสำหรับ Search หรือมีเนื้อหาซ้ำกับหน้าอื่นอย่างมาก
เว็บไซต์หนึ่งอาจมีสินค้าจริงเพียง 5,000 หน้า แต่ระบบสร้าง URL เพิ่มจาก Filter, Sort, Tag และ Search Result จนมี URL ที่ Google รู้จักหลายหมื่นหน้า
ในทางกลับกัน เว็บไซต์ข่าวที่มีบทความคุณภาพ 100,000 หน้าอาจไม่ถือว่ามี Index Bloat หากแต่ละหน้ามีเหตุผลในการคงอยู่และมีเนื้อหาที่แตกต่างกันจริง
ดังนั้น ตัวเลขจำนวน URL เพียงอย่างเดียวไม่สามารถบอกได้ว่าเกิดปัญหา
สิ่งที่ต้องดูคือ คุณค่าของแต่ละ URL เมื่อเทียบกับจำนวน URL ทั้งหมดที่ Search Engine ต้องประมวลผล
Google ระบุว่าในกระบวนการ Indexing ระบบจะพิจารณาว่าหน้าใดเป็น Duplicate และเลือก Canonical URL ที่เป็นตัวแทนของกลุ่มเนื้อหาที่คล้ายกัน
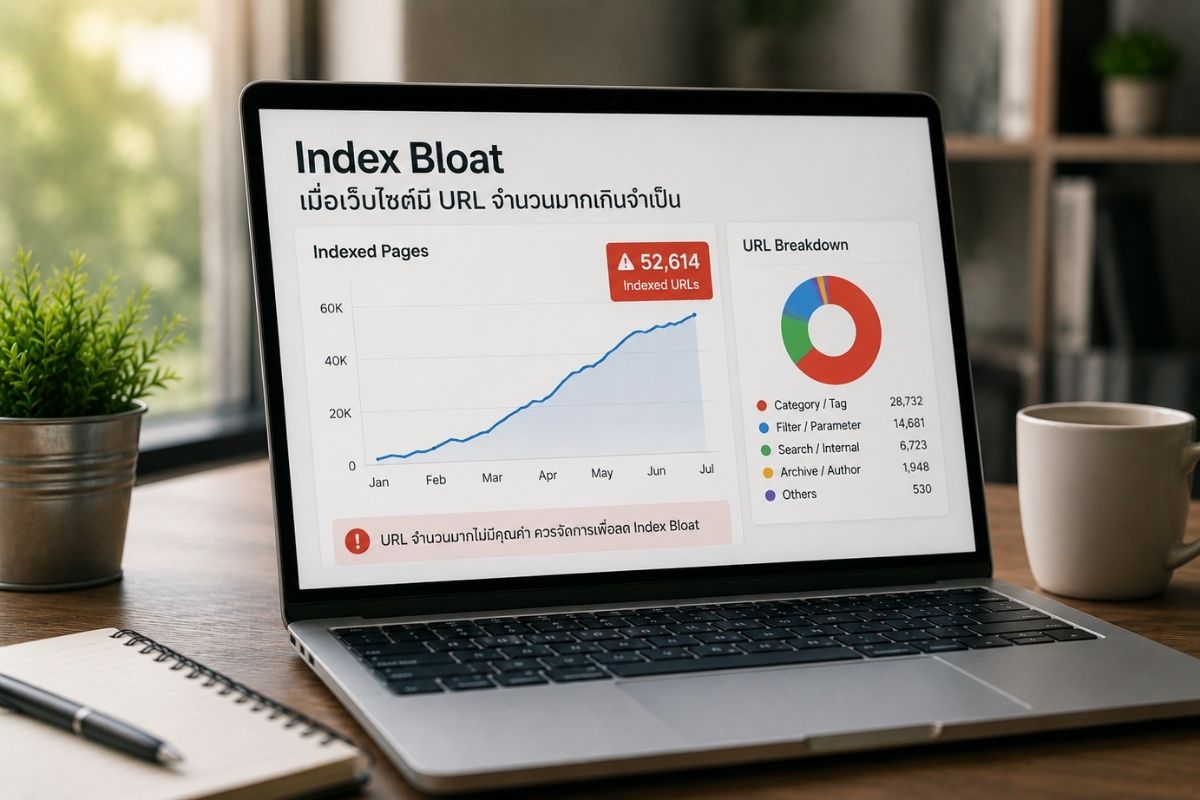
Index Bloat เกิดจาก URL ประเภทไหนบ่อยที่สุด
ปัญหามักไม่ได้เกิดจากบทความหลัก แต่เกิดจากระบบที่สร้างหน้าอัตโนมัติ
ตัวอย่างเช่นเว็บไซต์ E-commerce มีหน้าหมวด
/shoes
เมื่อผู้ใช้เลือกสี ราคา ขนาด และการเรียง ระบบอาจสร้าง
/shoes?color=black
/shoes?size=42
/shoes?sort=price
และยังสามารถผสม Parameter เหล่านี้เข้าด้วยกันอีกหลายรูปแบบ
Google เองแนะนำให้เว็บไซต์ใช้โครงสร้าง URL ที่ Crawl ได้อย่างมีประสิทธิภาพ เพราะ URL ที่ออกแบบไม่เหมาะสมสามารถทำให้ระบบ Crawl เว็บไซต์อย่างไม่มีประสิทธิภาพได้
นอกจาก Filter แล้ว ยังพบได้จาก Tag จำนวนมาก หน้า Search ภายใน Archive ผู้เขียน หน้าที่ไม่มีสินค้า หรือ URL ที่เข้าถึงเนื้อหาเดียวกันได้หลายรูปแบบ
Index Bloat กับ Duplicate Content เกี่ยวข้องกันอย่างไร
สองเรื่องนี้สัมพันธ์กันมาก แต่ไม่เหมือนกันทั้งหมด
Duplicate Content คือหลาย URL มีเนื้อหาเหมือนหรือใกล้เคียงกัน ส่วน Index Bloat มองภาพกว้างกว่านั้น เพราะรวมถึงหน้าที่อาจไม่ได้ซ้ำแบบตรง ๆ แต่ไม่มีคุณค่ามากพอที่จะต้องอยู่ใน Search
ตัวอย่างเช่น Tag Page ที่มีบทความเพียงหนึ่งรายการอาจไม่ได้ Duplicate กับหน้าอื่นทั้งหมด แต่ก็อาจไม่ได้มีประโยชน์มากพอที่จะเป็น Landing Page แยก
หากเว็บไซต์มี URL ซ้ำ Google สามารถเลือก Canonical URL เองได้ และเว็บไซต์ก็สามารถส่งสัญญาณ Canonical เพื่อบอก URL ที่ต้องการให้เป็นตัวแทนของกลุ่มหน้าที่ซ้ำหรือใกล้เคียงกัน
เป้าหมายจึงไม่ใช่กำจัด Duplicate ทุกกรณี แต่ควรลด URL ที่ไม่มีเหตุผลชัดเจนในการคงอยู่
Index Bloat ตรวจจาก Google Search Console อย่างไร
Google Search Console มี Page Indexing Report ซึ่งแสดงสถานะการ Index ของ URL ที่ Google รู้จักใน Property นั้น
เมื่อเปิดรายงาน ควรดูทั้งจำนวนหน้า Indexed และ Not Indexed พร้อมเหตุผลที่ระบบแสดง
ตัวอย่างสิ่งที่ควรสังเกตคือ เว็บไซต์มีเนื้อหาจริงประมาณ 500 หน้า แต่ Google รู้จัก URL หลายพันหรือหลายหมื่นหน้า
กรณีนี้ควรถามต่อว่า URL ส่วนเกินมาจากไหน
อาจใช้ URL Inspection ตรวจตัวอย่างแต่ละกลุ่มเพิ่มเติม เพราะเครื่องมือนี้สามารถแสดงข้อมูลเกี่ยวกับเวอร์ชันที่ Google จัดทำดัชนีและตรวจว่า URL มีแนวโน้ม Index ได้หรือไม่
สิ่งสำคัญคืออย่ามองตัวเลข Indexed สูงว่าเป็นเรื่องดีเสมอไป ต้องดูว่าหน้าที่ถูก Index เป็นหน้าที่ต้องการจริงหรือไม่
Index Bloat แบบไหนควรใช้ noindex
หากมีหน้าที่ผู้ใช้งานยังต้องเข้าถึงได้ แต่ไม่ต้องการให้ปรากฏใน Search noindex เป็นหนึ่งในเครื่องมือที่สามารถใช้ได้
Google ระบุว่าเมื่อ Googlebot Crawl หน้าและพบ noindex ระบบจะไม่นำหน้านั้นไปแสดงใน Google Search
ตัวอย่างที่อาจพิจารณาตามบริบท เช่น หน้า Search Result ภายในบางประเภท หรือหน้าระบบที่ไม่มีคุณค่าเป็น Landing Page จาก Search
แต่ไม่ควรนำ noindex ไปใส่ทุกหน้าที่ Traffic ต่ำ
บทความที่ยังไม่มี Traffic อาจเป็นเนื้อหาใหม่ หรือเป็นหัวข้อเฉพาะที่มีคุณค่ากับผู้ใช้บางกลุ่ม
ต้องตัดสินจากวัตถุประสงค์ของหน้า ไม่ใช่จำนวน Click เพียงอย่างเดียว
Index Bloat ควรแก้ด้วย Canonical, noindex หรือลบหน้า
แต่ละเครื่องมือมีวัตถุประสงค์ต่างกัน
หากหลาย URL แสดงเนื้อหาเดียวกันหรือใกล้เคียงกันมาก อาจพิจารณา Canonical
หากหน้ายังจำเป็นต่อผู้ใช้แต่ไม่ควรปรากฏใน Search อาจพิจารณา noindex
หากหน้าไม่มีคุณค่าและไม่จำเป็นต่อผู้ใช้อีกแล้ว อาจพิจารณาลบหรือรวมกับหน้าอื่น โดยจัดการ Status Code หรือ Redirect ให้เหมาะกับสถานการณ์
หากมีหน้าทดแทนที่เกี่ยวข้องจริง สามารถ Redirect ไปยังหน้าใหม่ได้
จุดสำคัญคือไม่ควรเลือกเครื่องมือเพียงเพราะต้องการลดจำนวน Indexed URL ให้เร็วที่สุด
ต้องแก้ต้นเหตุว่าทำไม URL เหล่านั้นถูกสร้างขึ้นก่อน
Index Bloat กับ XML Sitemap ควรตรวจพร้อมกัน
Sitemap ควรช่วยสื่อว่า URL ใดเป็นหน้าที่เว็บไซต์ต้องการนำเสนอให้ Search Engine
Google ระบุว่าเมื่อสร้าง Sitemap ควรใส่ Canonical URL ที่ต้องการให้ปรากฏใน Search มากกว่าการใส่ทุก URL ที่นำไปสู่เนื้อหาเดียวกัน
ดังนั้น หาก Sitemap มี Filter URL, URL ซ้ำ, Redirect URL หรือหน้า noindex จำนวนมาก ก็ควรตรวจสอบ
Sitemap ไม่ได้เป็นคำสั่งว่า Google ต้อง Index ทุก URL เพราะ Google ระบุว่าการมี URL ใน Sitemap ไม่รับประกันว่าจะถูก Crawl หรือ Index
แต่ Sitemap ที่สะอาดช่วยให้เว็บไซต์สื่อสารชุด URL สำคัญได้ชัดเจนขึ้น
วิธีลด Index Bloat แบบไม่เผลอลบหน้าที่มีค่า
ก่อนแก้เว็บไซต์ ควรแบ่ง URL ออกเป็นกลุ่มแล้วตัดสินใจตามประเภทแทนการแก้ทีละหน้าแบบสุ่ม
แนวทางตรวจพื้นฐานมีดังนี้
- ทำรายการ URL จาก Sitemap, CMS และ Search Console
- แยกหน้า Content, Product, Category, Tag, Filter และ Search
- ตรวจว่ากลุ่มใดสร้าง URL มากผิดปกติ
- หา URL ซ้ำและ Canonical ที่ระบบเลือก
- ตรวจหน้าที่ไม่มี Traffic แต่ยังมี Backlink หรือ Conversion
- ตัดสินใจ Keep, Improve, Merge, noindex หรือ Remove
- อัปเดต Sitemap และ Internal Link หลังแก้
- ติดตาม Page Indexing Report อีกครั้ง
สำหรับเว็บไซต์ขนาดใหญ่ โครงสร้าง Content และ URL มีผลต่อวิธีที่ Google Crawl และ Index เว็บไซต์มากขึ้น
สรุป
Index Bloat คือแนวคิดที่ใช้เรียกสถานการณ์ที่เว็บไซต์มี URL จำนวนมากเกินความจำเป็นสำหรับ Search โดยอาจเกิดจาก Filter, Tag, Search Page, Parameter, Duplicate URL หรือหน้าที่ไม่มีคุณค่ามากพอ การแก้ไม่ได้หมายถึงลดจำนวน Indexed Page ให้เหลือน้อยที่สุด แต่ต้องทำให้ URL ที่ Google พบและประเมินมีความสัมพันธ์กับเนื้อหาที่เว็บไซต์ต้องการนำเสนอจริง เจ้าของเว็บไซต์ควรเริ่มจาก Google Search Console แล้วแบ่ง URL เป็นกลุ่ม ตรวจ Canonical, noindex, Sitemap และ Internal Link ก่อนตัดสินใจแก้ไข หากจัดระบบได้ดี เว็บไซต์จะมีโครงสร้าง URL ที่สะอาดขึ้นและลดการใช้ทรัพยากรกับหน้าที่ไม่มีความจำเป็น
คำถามที่พบบ่อย (FAQ)
Index Bloat คืออะไร?
Index Bloat เป็นคำในวงการ SEO ที่ใช้เรียกสถานการณ์ซึ่งเว็บไซต์มี URL จำนวนมากที่ไม่มีความจำเป็นหรือคุณค่ามากพอสำหรับการแสดงใน Search
เว็บไซต์มี Indexed Page เยอะถือว่าดีหรือไม่?
ไม่เสมอไป สิ่งสำคัญคือหน้าที่ถูก Index ต้องเป็นหน้าที่มีคุณค่าและเว็บไซต์ต้องการนำเสนอ ไม่ใช่ดูจำนวนหน้าให้มากที่สุด
Tag Page ทำให้เกิด Index Bloat หรือไม่?
เป็นไปได้ หากเว็บไซต์สร้าง Tag จำนวนมากจนเกิดหน้าที่มีข้อมูลน้อยหรือคล้ายกัน แต่ Tag Page ที่มีโครงสร้างและประโยชน์ต่อผู้ใช้ก็สามารถมีคุณค่าได้
noindex ช่วยแก้ Index Bloat ได้หรือไม่?
ช่วยได้ในบางกรณี แต่ควรใช้กับหน้าที่ไม่ต้องการให้ปรากฏใน Search จริง ๆ ไม่ควรใช้เป็นวิธีแก้ทุก URL ที่ Traffic ต่ำ
ตรวจ Index Bloat ได้ที่ไหน?
สามารถเริ่มจาก Page Indexing Report ใน Google Search Console แล้วเปรียบเทียบจำนวน URL ที่ Google รู้จักกับจำนวนหน้าที่เว็บไซต์ต้องการให้ Search Engine ค้นพบ