SEO Article
Crawl Budget คืออะไร? Googlebot เลือก Crawl เว็บไซต์อย่างไร
Crawl Budget คืออะไร? ทำไมบางหน้าในเว็บไซต์ Google ถึงเข้ามาเก็บข้อมูลช้ากว่าหน้าอื่น
เว็บไซต์หนึ่งอาจมีหน้าเพียงไม่กี่สิบหน้า ขณะที่อีกเว็บไซต์มีบทความ สินค้า หมวดหมู่ และ URL รวมกันหลายหมื่นหน้า แต่ Google ไม่จำเป็นต้องเข้ามาตรวจทุก URL ด้วยความถี่เท่ากัน ระบบต้องเลือกว่าจะเข้าไปสำรวจหน้าใด เมื่อใด และมากน้อยเพียงใด แนวคิดที่เกี่ยวข้องกับเรื่องนี้เรียกว่า Crawl Budget ซึ่งมักได้รับความสนใจเมื่อเว็บไซต์มีขนาดใหญ่หรือมี URL เพิ่มขึ้นอย่างต่อเนื่อง สำหรับเว็บไซต์ขนาดเล็กทั่วไป Crawl Budget อาจยังไม่ใช่ปัญหาหลัก แต่การเข้าใจหลักการไว้ช่วยป้องกันการสร้าง URL ที่ไม่มีประโยชน์จำนวนมาก และช่วยให้โครงสร้างเว็บไซต์ชัดเจนขึ้น บทความนี้จะอธิบาย Crawl Budget ด้วยภาษาง่าย ๆ พร้อมแนวทางตรวจสอบว่าควรให้ความสำคัญกับเรื่องนี้เมื่อใด
Crawl Budget คืออะไร เข้าใจง่าย ๆ จากการทำงานของ Googlebot
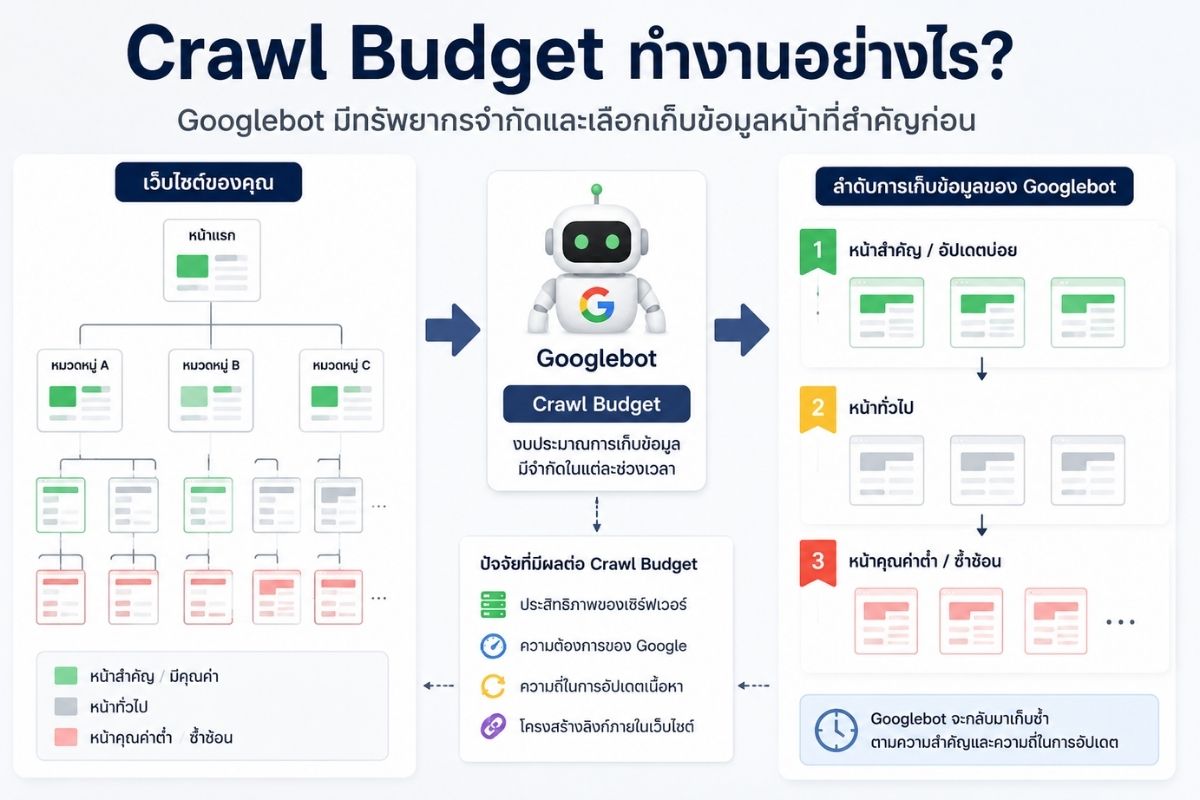
Crawl Budget อธิบายโดยทั่วไปถึงปริมาณและความสามารถที่ Googlebot ใช้ในการ Crawl URL ของเว็บไซต์ภายในช่วงเวลาหนึ่ง โดย Google อธิบายแนวคิดนี้ผ่านองค์ประกอบที่เกี่ยวข้อง เช่น Crawl Capacity Limit และ Crawl Demand
Crawl Capacity Limit เกี่ยวข้องกับขีดจำกัดที่ Googlebot สามารถ Crawl เว็บไซต์ได้โดยไม่สร้างภาระต่อระบบมากเกินไป ส่วน Crawl Demand เกี่ยวข้องกับความต้องการของ Google ในการกลับมา Crawl URL ต่าง ๆ
จึงไม่ควรเข้าใจว่าเว็บไซต์แต่ละแห่งได้รับ “โควตา” เป็นตัวเลขตายตัว เช่น 1,000 หน้าต่อวัน
การ Crawl สามารถเปลี่ยนแปลงได้ตามเว็บไซต์ สถานะของ Server ความนิยมของ URL การอัปเดตเนื้อหา และปัจจัยอื่น
Google ระบุด้วยว่าเว็บไซต์ส่วนใหญ่ไม่จำเป็นต้องกังวลเรื่อง Crawl Budget มากนัก โดยประเด็นนี้มีความสำคัญมากขึ้นกับเว็บไซต์ขนาดใหญ่หรือเว็บไซต์ที่มี URL เปลี่ยนแปลงรวดเร็ว
Crawl Budget ไม่ได้หมายความว่า Crawl แล้วจะ Index ทันที
จุดหนึ่งที่ทำให้ผู้เริ่มต้นสับสนคือคำว่า Crawl กับ Index
เมื่อ Googlebot เข้ามา Crawl หมายความว่าระบบเข้าไปดาวน์โหลดหรือสำรวจข้อมูลของ URL แต่ไม่ได้หมายความว่าหน้านั้นจะต้องได้รับการ Index และปรากฏบน Google เสมอ
หลังจาก Crawl แล้ว Google ยังต้องประมวลผลและพิจารณาหน้านั้นอีก
ดังนั้น หากบทความใหม่ยังไม่ปรากฏในผลการค้นหา ไม่ควรสรุปทันทีว่าเกิดจาก Crawl Budget
ปัญหาอาจมาจากหลายเรื่อง เช่น Google ยังไม่ค้นพบ URL เนื้อหาใกล้เคียงกับหน้าอื่นมากเกินไป Canonical ชี้ไปหน้าอื่น หรือ Google ประเมินแล้วว่ายังไม่ควรนำ URL นั้นเข้าสู่ดัชนี
การวิเคราะห์จึงต้องแยกขั้นตอนการค้นพบ การ Crawl และการ Index ออกจากกัน
Crawl Budget สำคัญกับเว็บไซต์แบบไหนมากที่สุด
หากเว็บไซต์มีบทความ 50 หรือ 100 หน้า และโครงสร้างปกติ Google สามารถเข้าถึงหน้าเหล่านั้นได้ง่าย เจ้าของเว็บมักไม่จำเป็นต้องหมกมุ่นกับ Crawl Budget
กลุ่มเว็บไซต์ที่ควรสนใจมากขึ้น เช่น
- E-commerce ที่มีสินค้าจำนวนมาก
- Marketplace
- เว็บไซต์ข่าวขนาดใหญ่
- เว็บประกาศที่มี URL เพิ่มขึ้นทุกวัน
- เว็บไซต์ที่สร้าง URL จากตัวกรองจำนวนมาก
- เว็บไซต์ที่มีหน้าหลายแสนหรือหลายล้าน URL
- เว็บไซต์ขนาดกลางขึ้นไปที่มีหน้าเปลี่ยนแปลงรวดเร็ว
สำหรับเว็บไซต์เหล่านี้ หากระบบสร้าง URL ที่ไม่มีคุณค่าจำนวนมาก Googlebot อาจใช้เวลาไปกับ URL เหล่านั้นแทนที่จะเข้าถึงหน้าสำคัญอย่างมีประสิทธิภาพ
Crawl Budget กับ URL ที่ไม่มีประโยชน์จำนวนมาก
ลองนึกถึงร้านค้าออนไลน์ที่มีสินค้า 10,000 รายการ แต่ระบบ Filter สามารถสร้าง URL ตามสี ราคา ขนาด การเรียงลำดับ และตัวเลือกอื่นได้หลายรูปแบบ
จากสินค้า 10,000 หน้า อาจกลายเป็น URL ที่ระบบสามารถค้นพบได้มากกว่านั้นหลายเท่า
URL บางชุดอาจแสดงเนื้อหาคล้ายกันมาก หรือแทบไม่มีคุณค่าต่อการค้นหา
นี่เป็นตัวอย่างว่าทำไมการออกแบบโครงสร้าง URL จึงสำคัญ
Google ยังกล่าวถึงปัจจัยที่อาจทำให้เสียทรัพยากรการ Crawl เช่น Faceted Navigation และ URL ที่มีเนื้อหาซ้ำบางประเภท
จุดประสงค์จึงไม่ใช่การทำให้ Google Crawl “เยอะที่สุด” แต่เป็นการทำให้ระบบเข้าถึง URL ที่ควรได้รับความสนใจได้อย่างเหมาะสม
Crawl Budget กับความเร็วของ Server เกี่ยวข้องกันอย่างไร
Googlebot ไม่ได้เข้ามา Crawl โดยไม่สนใจความสามารถของ Server
หากเว็บไซต์ตอบสนองรวดเร็วและรองรับ Request ได้ดี ระบบอาจสามารถ Crawl ได้อย่างมีประสิทธิภาพมากกว่าเว็บไซต์ที่ Server ตอบสนองช้า หรือเกิดข้อผิดพลาดฝั่ง Server บ่อยครั้ง
ในทางกลับกัน หาก Google ตรวจพบสัญญาณว่า Server กำลังมีปัญหา อัตราการ Crawl สามารถลดลงเพื่อหลีกเลี่ยงการสร้างภาระเพิ่มเติมให้เว็บไซต์ได้
ดังนั้น เว็บไซต์ขนาดใหญ่จึงควรดูทั้ง SEO และประสิทธิภาพของ Hosting หรือ Server ควบคู่กัน
วิธีช่วยให้ Crawl Budget ถูกใช้กับหน้าที่มีคุณค่า
การจัดการ Crawl Budget ไม่ควรเริ่มด้วยการพยายามบังคับ Googlebot แต่ควรเริ่มจากการจัดเว็บไซต์ให้สะอาดและเป็นระบบ
แนวทางพื้นฐาน ได้แก่
- ลด URL ซ้ำที่ไม่จำเป็น
- แก้ Soft 404 และหน้า Error จำนวนมาก
- จัดการ Faceted Navigation อย่างเหมาะสม
- ทำ Internal Link ไปยังหน้าสำคัญ
- ใช้ Sitemap ที่มี URL ซึ่งต้องการให้ Google รู้จัก
- ตรวจ Redirect Chain ที่ยาวโดยไม่จำเป็น
- ดูแล Server ให้ตอบสนองได้ตามปกติ
- ตรวจว่าระบบไม่ได้สร้าง URL จำนวนมากโดยไม่มีจุดประสงค์
โดยเฉพาะ Sitemap ควรเป็นรายการ URL ที่มีคุณภาพและต้องการนำเสนอให้ Google มากกว่าการนำทุก URL ที่ระบบสร้างได้ใส่ลงไปทั้งหมด
Crawl Budget ตรวจสอบจาก Google Search Console ได้หรือไม่
Google Search Console มี Crawl Stats report ที่ช่วยให้เจ้าของเว็บไซต์ดูข้อมูลการ Crawl ของ Googlebot ได้
ข้อมูลที่สามารถนำมาวิเคราะห์ได้ เช่น จำนวน Crawl Request ปริมาณข้อมูลที่ดาวน์โหลด เวลาตอบสนองโดยเฉลี่ย รวมถึงรายละเอียดตาม Response Code หรือประเภทไฟล์
ตัวอย่างเช่น หากพบว่า Googlebot ใช้ Request จำนวนมากกับ URL ที่ Redirect หรือ URL ที่เกิด Error ก็เป็นจุดเริ่มต้นสำหรับตรวจสอบโครงสร้างเว็บไซต์เพิ่มเติม
อย่างไรก็ตาม ไม่ควรดูตัวเลขจำนวน Crawl อย่างเดียว ต้องพิจารณาว่า Googleกำลัง Crawl “อะไร” ด้วย
Crawl Budget ไม่ควรแก้ด้วยการบล็อกทุกอย่าง
เมื่อเห็น Googlebot เข้า URL ที่ไม่ต้องการ หลายคนอาจคิดว่าการใส่ Disallow ใน robots.txt คือคำตอบสำหรับทุกกรณี
แต่ robots.txt มีหน้าที่ควบคุมการ Crawl ไม่ใช่เครื่องมือสำหรับสั่งให้ URL หายออกจาก Google โดยตรง
การจัดการ URL แต่ละประเภทจึงต้องเลือกวิธีตามปัญหา เช่น Redirect, Canonical, noindex หรือปรับโครงสร้างเว็บไซต์
หากใช้ผิดวิธี อาจทำให้ Googlebot เข้าไม่ถึงข้อมูลที่จำเป็นสำหรับประเมิน URL นั้น
จึงควรวิเคราะห์ก่อนเสมอว่าต้องการแก้ปัญหาเรื่อง Crawling, Indexing หรือ Duplicate URL เพราะแต่ละเรื่องอาจต้องใช้วิธีแตกต่างกัน
สรุป
Crawl Budget เป็นแนวคิดเกี่ยวกับทรัพยากรและความต้องการที่ Google ใช้ในการ Crawl URL ภายในเว็บไซต์ โดยมีความสำคัญเป็นพิเศษกับเว็บไซต์ขนาดใหญ่ เว็บไซต์ที่อัปเดตบ่อย หรือระบบที่สามารถสร้าง URL จำนวนมาก เจ้าของเว็บไซต์ขนาดเล็กทั่วไปไม่จำเป็นต้องพยายามเพิ่ม Crawl Budget โดยไม่มีเหตุผล สิ่งที่ควรให้ความสำคัญมากกว่าคือการสร้างโครงสร้างเว็บไซต์ที่ชัดเจน ลด URL ที่ไม่มีคุณค่า ดูแล Internal Link, Sitemap และ Server ให้ทำงานอย่างเหมาะสม พร้อมตรวจข้อมูลจาก Google Search Console เมื่อเว็บไซต์มีขนาดใหญ่ขึ้น เป้าหมายไม่ใช่ทำให้ Googlebot เข้ามามากที่สุด แต่คือช่วยให้การ Crawl ที่เกิดขึ้นมุ่งไปยังหน้าที่มีประโยชน์และสำคัญต่อเว็บไซต์
คำถามที่พบบ่อย (FAQ)
Crawl Budget คืออะไร?
Crawl Budget เป็นแนวคิดที่เกี่ยวข้องกับทรัพยากรและความต้องการในการที่ Googlebot เข้ามา Crawl URL ของเว็บไซต์ โดยมีความสำคัญมากขึ้นเมื่อเว็บไซต์มี URL จำนวนมาก
เว็บไซต์เล็กต้องสนใจ Crawl Budget หรือไม่?
เว็บไซต์ขนาดเล็กที่มีโครงสร้างปกติและมี URL ไม่มาก โดยทั่วไปไม่จำเป็นต้องให้ความสำคัญกับ Crawl Budget มากเท่าเว็บไซต์ขนาดใหญ่
Google Crawl หน้าแล้วแปลว่าจะ Index หรือไม่?
ไม่เสมอไป การ Crawl และ Index เป็นคนละขั้นตอน Google สามารถ Crawl URL แล้วตัดสินใจไม่นำ URL นั้นเข้าสู่ดัชนีได้
Sitemap ช่วยเรื่อง Crawl Budget หรือไม่?
Sitemap ช่วยให้ Google รู้จัก URL ที่เว็บไซต์ต้องการนำเสนอ แต่ไม่ได้เป็นคำสั่งบังคับให้ Google Crawl หรือ Index ทุก URL ที่อยู่ใน Sitemap
จะรู้ได้อย่างไรว่า Googlebot เข้ามา Crawl เว็บไซต์มากแค่ไหน?
เจ้าของเว็บไซต์สามารถดูข้อมูลได้จาก Crawl Stats report ภายใน Google Search Console และเว็บไซต์ขนาดใหญ่อาจวิเคราะห์ Server Log เพิ่มเติมเพื่อดูพฤติกรรมการ Crawl อย่างละเอียด